
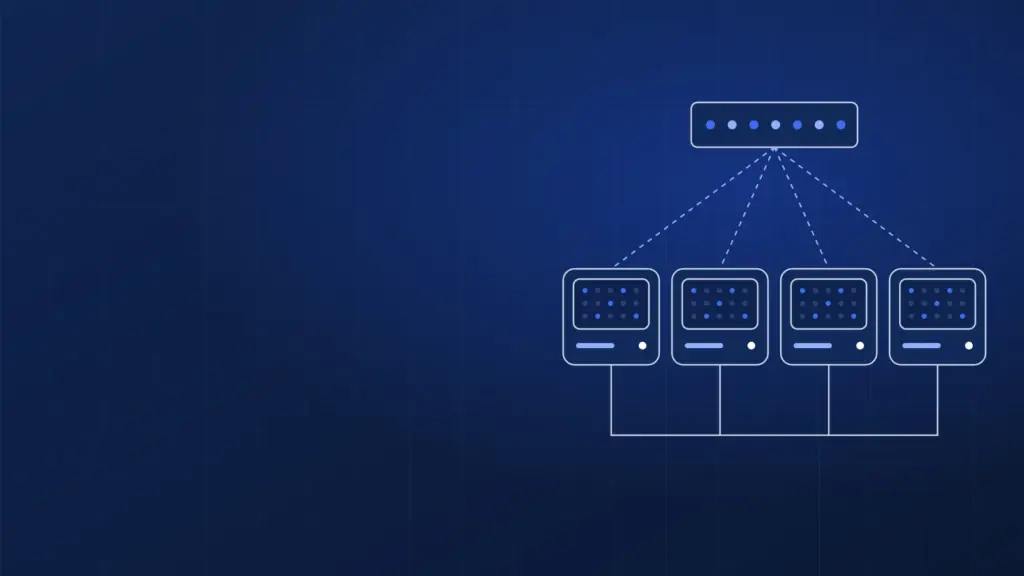
Jeden DGX Spark ma 128 GB pamięci i uruchamia modele do ok. 200 mld parametrów. Klaster DGX Spark z dwóch urządzeń połączonych kablem QSFP 200 Gb/s daje 256 GB i modele do ok. 400B, a cztery urządzenia za przełącznikiem 200 GbE – 512 GB i modele do ok. 700B. Wyjaśniamy, jak to działa, które modele naprawdę się mieszczą i gdzie kończy się sens takiego rozwiązania.
O klastrowaniu DGX Spark pisze się najczęściej w kategoriach „700 mld parametrów na biurku”. Liczba robi wrażenie, ale za nią stoją konkretne założenia: kwantyzacja 4-bitowa, ograniczony kontekst i świadomość, że klaster zwiększa przede wszystkim pojemność pamięci, a nie szybkość. Budujemy i utrzymujemy takie klastry w naszej serwerowni Tier III w Polsce, więc poniżej opisujemy je od strony inżynierskiej, z rachunkiem pamięci dla aktualnych modeli open-weight.
Po co łączyć DGX Spark w klaster
Pojedynczy DGX Spark to układ GB10 Grace Blackwell ze 128 GB pamięci LPDDR5X wspólnej dla CPU i GPU. Według NVIDIA wystarcza to do inferencji modeli do 200B parametrów i fine-tuningu do 70B. Wiele najciekawszych modeli otwartych z 2026 roku jest jednak większych: Llama 4 Maverick ma ok. 400B parametrów, GLM-5.3 ok. 753B, a DeepSeek-V4.1-Flash ok. 763B. Żaden z nich nie zmieści się w 128 GB nawet w 4 bitach.
Klaster rozwiązuje problem pojemności. Model dzieli się na części, każda trafia do pamięci innego urządzenia, a urządzenia wymieniają dane przez sieć. Dzięki temu zespół może pracować z modelem klasy 400B–700B bez wynajmowania serwera z ośmioma GPU HBM, który jest znacznie droższy, a w fazie eksperymentów często stoi bezczynnie.
Dwie konfiguracje klastra DGX Spark
NVIDIA przewiduje dwie konfiguracje. Każde urządzenie ma kartę ConnectX-7 z dwoma portami QSFP 200 Gb/s, przeznaczonymi właśnie do łączenia urządzeń.
| Konfiguracja | Połączenie | Pamięć łącznie | Modele (wg NVIDIA) | Typowe zastosowanie |
|---|---|---|---|---|
| 1 urządzenie | – | 128 GB | do 200B (inferencja), do 70B (fine-tuning) | prototypy, fine-tuning, mały zespół |
| Klaster 2 urządzeń | bezpośredni kabel QSFP 200 Gb/s | 256 GB | do ok. 400B | modele 200B–400B w 4 bitach, modele 120B–180B w FP8 |
| Klaster 4 urządzeń | przełącznik 200 GbE | 512 GB | do ok. 700B | duże modele MoE w 4 bitach, modele ok. 300B–400B w FP8 |
Dwa urządzenia: 256 GB bez przełącznika
Najprostszy wariant. Dwa DGX Spark łączymy bezpośrednio kablem QSFP, bez dodatkowego sprzętu sieciowego. Połączenie punkt–punkt ma najmniejsze opóźnienia, co jest ważne przy podziale każdej warstwy modelu między urządzenia (o tym niżej). To dobra konfiguracja dla zespołu, który pracuje z modelami 200B–400B albo chce uruchamiać modele średniej wielkości w wyższej precyzji niż 4 bity.
Cztery urządzenia: 512 GB za przełącznikiem 200 GbE
Przy czterech urządzeniach połączenie każdy z każdym kablami przestaje być praktyczne, dlatego potrzebny jest przełącznik 200 GbE. Dochodzi jeden element sieci do skonfigurowania i monitorowania, ale w zamian dostajesz 512 GB pamięci – dość, by uruchomić modele ok. 700B w 4 bitach. W naszej serwerowni przełącznik, okablowanie i konfiguracja sieci są częścią usługi.
Które modele zmieszczą się w klastrze DGX Spark – rachunek pamięci
Rachunek jest prosty: wagi to liczba parametrów razy bajty na parametr. W 4 bitach to ok. 0,5 bajta, w FP8 1 bajt, w BF16 2 bajty. Do tego trzeba doliczyć 10–20% narzutu, pamięć na KV cache (rośnie z długością kontekstu i liczbą równoczesnych zapytań) oraz to, czego na każdym urządzeniu potrzebuje system operacyjny. Szczegółowo opisujemy to w artykule Ile VRAM potrzebuje model językowy.
Ważna uwaga o modelach MoE (mixture of experts): przy każdym tokenie liczą one tylko część parametrów, tzw. aktywne, ale w pamięci muszą mieć wszystkie. Do rachunku pamięci zawsze bierzemy więc łączną liczbę parametrów.
Poniżej przykłady dla modeli open-weight, stan na listopad 2026 (rynek zmienia się co miesiąc). Kolumny z wagami pokazują same wagi, bez narzutu i KV cache.
| Model | Parametry łącznie | Wagi w 4 bitach | Wagi w FP8 | Gdzie się zmieści |
|---|---|---|---|---|
| Mistral Medium 3.5 | 128B | ok. 64 GB | ok. 128 GB | 4 bity: 1 urządzenie; FP8: klaster 2 |
| Qwen3.8-Flash-Next | 180B | ok. 90 GB | ok. 180 GB | 4 bity: 1 urządzenie (na granicy), wygodnie klaster 2; FP8: klaster 2 |
| GLM-5.3-Flash | ok. 321B | ok. 161 GB | ok. 321 GB | 4 bity: klaster 2; FP8: klaster 4 |
| Llama 4 Maverick | ok. 400B | ok. 200 GB | ok. 400 GB | 4 bity: klaster 2 (ciasno, krótki kontekst), wygodnie klaster 4; FP8: klaster 4, na granicy |
| GLM-5.3 | ok. 753B | ok. 377 GB | ok. 753 GB | 4 bity: klaster 4, na granicy; FP8: nie |
| DeepSeek-V4.1-Flash | ok. 763B | ok. 382 GB | ok. 763 GB | 4 bity: klaster 4, na granicy; FP8: nie |
| Mistral Large 4 (52B aktywnych) | ok. 1T | ok. 500 GB | ok. 1 TB | nie mieści się – serwer HGX |
| Kimi K2.7-Code | ok. 1,03T | ok. 515 GB | ok. 1,03 TB | nie mieści się – serwer HGX |
| DeepSeek-V4-Pro | ok. 1,65T | ok. 825 GB | ok. 1,65 TB | nie mieści się – HGX B200 (4 bity) lub HGX B300 |
Kilka wniosków z tej tabeli:
- Model ok. 400B na dwóch urządzeniach jest możliwy, ale ciasny. 200 GB wag plus 10–20% narzutu daje ok. 220–240 GB z 256 GB. Na KV cache zostaje niewiele, więc kontekst i liczba równoczesnych zapytań będą mocno ograniczone. Na czterech urządzeniach ten sam model ma dużo luzu.
- GLM-5.3 i DeepSeek-V4.1-Flash są nieco powyżej orientacyjnej granicy ok. 700B podawanej przez NVIDIA. Same wagi w 4 bitach (ok. 380 GB) mieszczą się w 512 GB, ale po doliczeniu narzutu zostaje mało miejsca na kontekst. Traktujemy to jako konfigurację do testów, a nie do codziennej pracy z długimi dokumentami.
- Modele 1T i większe nie są dla klastra DGX Spark. Mistral Large 4, Kimi K2.7-Code, DeepSeek-V4-Pro, a tym bardziej Kimi K3 (ok. 2,78T) czy Qwen3.8-2.4T wymagają serwerów z pamięcią HBM.
- Kwantyzacja 4-bitowa ma swoją cenę. Nowoczesne metody zwykle zachowują jakość bliską oryginałowi, ale zawsze sprawdzaj to na własnych zadaniach. Więcej o kompromisach piszemy w tekście o redukcji kosztów dzięki kwantyzacji.
Rozmiar to nie jedyne kryterium. Licencje dużych modeli bywają niestandardowe (np. GLM-5.3, Llama 4, Mistral Large 4), więc przed wdrożeniem warto sprawdzić warunki użycia komercyjnego. Porównanie modeli razem z licencjami znajdziesz w artykule Najlepsze modele open source do self-hostingu w 2026.
Jak działa inferencja rozproszona
Gdy model nie mieści się w pamięci jednego urządzenia, serwer inferencji (np. vLLM, SGLang albo TensorRT-LLM) dzieli go między kilka urządzeń. Są dwa podstawowe sposoby i w praktyce często się je łączy.
Równoległość tensorowa (tensor parallelism)
Każda warstwa modelu jest dzielona na kawałki: macierze wag rozkłada się między urządzenia i każde liczy swoją część. Po każdej warstwie urządzenia muszą wymienić wyniki częściowe. Zaletą jest to, że przy generowaniu tokenu wszystkie urządzenia pracują jednocześnie i każde czyta ze swojej pamięci tylko część wag. Wadą jest bardzo częsta komunikacja: synchronizacja po każdej warstwie, czyli dziesiątki, a nawet setki wymian danych na każdy token. W serwerach HGX odbywa się ona przez NVLink 1,8 TB/s. W klastrze DGX Spark przez sieć 200 Gb/s, czyli ok. 25 GB/s, z wyraźnie większymi opóźnieniami. Dlatego ten tryb najlepiej sprawdza się przy bezpośrednim połączeniu dwóch urządzeń.
Równoległość potokowa (pipeline parallelism)
Model dzieli się na grupy kolejnych warstw: pierwsze urządzenie liczy warstwy od 1 do N, drugie od N+1 do 2N i tak dalej. Między urządzeniami przesyła się tylko aktywacje na granicy grup, czyli niewiele danych, więc ten tryb jest mniej wrażliwy na sieć. W zamian pojedyncze zapytanie przechodzi przez urządzenia po kolei – klaster zyskuje pojemność, ale jedna odpowiedź nie przyspiesza. Przy wielu równoczesnych zapytaniach potok wypełnia się i wykorzystanie sprzętu rośnie.
Karty ConnectX-7 obsługują RDMA, więc komunikacja między urządzeniami omija stos TCP/IP systemu operacyjnego, co zmniejsza opóźnienia. Mimo to dobór trybu i jego parametrów to kwestia testów na konkretnym modelu i obciążeniu, a nie jednej uniwersalnej konfiguracji.
Ograniczenia klastra DGX Spark
Klaster to sposób na uruchomienie dużego modelu przy rozsądnym koszcie, a nie zamiennik serwera produkcyjnego. Ograniczenia warto znać przed decyzją:
- Przepustowość pamięci 273 GB/s na urządzenie. Generowanie tekstu jest ograniczone szybkością odczytu wag. Duże modele gęste będą działać wolno. Modele MoE wypadają lepiej, bo przy każdym tokenie czytają tylko aktywne parametry.
- Sieć zamiast NVLink. 200 Gb/s to dużo jak na sieć, ale wielokrotnie mniej niż połączenia GPU–GPU w systemach HGX. Część mocy obliczeniowej zjada komunikacja.
- Cztery urządzenia nie są cztery razy szybsze. Klaster skaluje przede wszystkim pojemność pamięci. Przyrost szybkości jest mniejszy niż liczba urządzeń, a w trybie potokowym dla pojedynczego zapytania może go w ogóle nie być.
- Brak redundancji. Model jest podzielony między wszystkie urządzenia, więc awaria jednego zatrzymuje cały klaster. Cztery urządzenia to cztery potencjalne punkty awarii.
- Mało miejsca na kontekst przy największych modelach. Gdy wagi zajmują większość pamięci, długi kontekst i wielu użytkowników naraz przestają się mieścić.
- Dojrzałość oprogramowania. Nie każdy model i nie każda kombinacja narzędzi jest równie dobrze przetestowana w trybie wielowęzłowym na architekturze Arm. Przed zobowiązaniem się do konkretnego modelu warto go uruchomić i zmierzyć.
Kiedy przejść z klastra DGX Spark na serwer HGX
Klaster DGX Spark dobrze sprawdza się w R&D, przy prototypach na dużych modelach i w pracy małego zespołu. Na serwer HGX warto przejść, gdy:
- model ma trafić do produkcji z wieloma równoczesnymi użytkownikami i wymaganiami co do czasu odpowiedzi,
- potrzebujesz modelu powyżej ok. 700B parametrów albo dużego modelu w FP8 lub BF16 zamiast 4 bitów,
- potrzebujesz długiego kontekstu (np. analiza dużych zbiorów dokumentów) przy dużym modelu,
- planujesz pełny fine-tuning lub trening, a nie tylko inferencję i LoRA,
- usługa wymaga wysokiej dostępności, czyli co najmniej dwóch niezależnych serwerów.
Dla porównania: HGX B200 to 8 GPU po 180 GB HBM3e, czyli ok. 1,44 TB pamięci połączonej przez NVLink 1,8 TB/s. HGX B300 ma 8 GPU po 288 GB, ok. 2,3 TB na system. W takim serwerze DeepSeek-V4-Pro w 4 bitach (ok. 825 GB wag) mieści się z dużym zapasem na kontekst. Takie systemy oferujemy jako serwery GPU w modelu usługi albo jako sprzęt Supermicro do zakupu z kolokacją w naszej serwerowni. Pełne porównanie szczebli od DGX Spark do HGX znajdziesz w artykule DGX Spark, RTX PRO 6000 czy HGX B200.
Klaster DGX Spark jako usługa
Klaster budujemy i utrzymujemy w naszej serwerowni Tier III z certyfikatem ISO 27001. W ramach usługi:
- dobieramy konfigurację (2 czy 4 urządzenia) do modelu, precyzji i potrzebnej długości kontekstu,
- łączymy urządzenia (kabel QSFP albo przełącznik 200 GbE) i konfigurujemy sieć,
- instalujemy DGX OS i stos do inferencji rozproszonej, uruchamiamy model i wystawiamy go przez API zgodne z OpenAI,
- monitorujemy każde urządzenie i sieć między nimi, robimy kopie konfiguracji i danych,
- dajemy dostęp przez VPN i SSH, z pełnym rootem albo z administracją po naszej stronie.
Jeśli zaczynasz od jednego urządzenia, możesz rozbudować je do klastra bez przenoszenia danych. Jak wygląda sama usługa dla pojedynczego urządzenia, opisujemy w artykule NVIDIA DGX Spark jako usługa. Wycena jest indywidualna i zależy od liczby urządzeń, okresu umowy oraz zakresu administracji.
FAQ: najczęściej zadawane pytania
Ile pamięci ma klaster DGX Spark?
Każde urządzenie ma 128 GB pamięci zunifikowanej. Klaster dwóch urządzeń ma łącznie 256 GB, klaster czterech – 512 GB. Część tej pamięci zajmuje system operacyjny na każdym urządzeniu, więc dla modelu i kontekstu zostaje nieco mniej.
Czy dwa DGX Spark uruchomią model 405B?
Tak, w kwantyzacji 4-bitowej, ale ciasno. Model 405B w 4 bitach to ok. 203 GB wag, a z narzutem ok. 220–245 GB z dostępnych 256 GB. Kontekst i liczba równoczesnych zapytań będą mocno ograniczone. Do wygodnej pracy z takim modelem lepszy jest klaster czterech urządzeń.
Czy cztery DGX Spark są cztery razy szybsze niż jeden?
Nie. Klaster zwiększa przede wszystkim pojemność pamięci, czyli rozmiar modelu, który da się uruchomić. Komunikacja przez sieć 200 Gb/s kosztuje czas, a w trybie potokowym pojedyncze zapytanie przechodzi przez urządzenia po kolei.
Czy na klastrze DGX Spark uruchomię DeepSeek?
DeepSeek-V4.1-Flash (ok. 763B) w 4 bitach to ok. 382 GB wag, które mieszczą się w klastrze czterech urządzeń, choć z małym zapasem na kontekst. DeepSeek-V4-Pro (ok. 1,65T) wymaga już serwera HGX.
Ile kosztuje klaster DGX Spark jako usługa?
Wycena jest indywidualna. Zależy od liczby urządzeń (2 lub 4), okresu umowy i tego, czy administrację prowadzimy my, czy Twój zespół.
Klaster DGX Spark czy serwer HGX B200?
Klaster DGX Spark wybierz do R&D, prototypów i pracy małego zespołu z modelem 200B–700B. HGX B200 – do produkcji z wieloma użytkownikami, do modeli powyżej 700B, do wyższej precyzji i do treningu.
Chcesz uruchomić model 400B–700B na własnym, prywatnym sprzęcie w Polsce? Opisz nam model i sposób pracy zespołu, a dobierzemy konfigurację klastra i przygotujemy wycenę. Szczegóły znajdziesz na stronie DGX Spark jako usługa, a zapytanie wyślesz przez formularz kontaktowy.